
市面上每一家企业级 AI 智能体平台都宣称自己的解决率很高。厂商的演示文稿看多了,这些数字就开始变得模糊难辨。这正是该领域当下不显眼的问题:当所有人都宣称同样的结果,买家便不再相信其中任何一个,而本该最重要的指标也沦为背景噪音。
只有一个例外。当一个数字由客户亲自得出——在他们自己的条件下,面对他们自己的客户——它就不再是营销话术。这正是厂商说“我们的智能体能解决大多数问题”与买家亲自测试并看到大多数问题被解决之间的区别。
Thumbtack 亲自做了测试
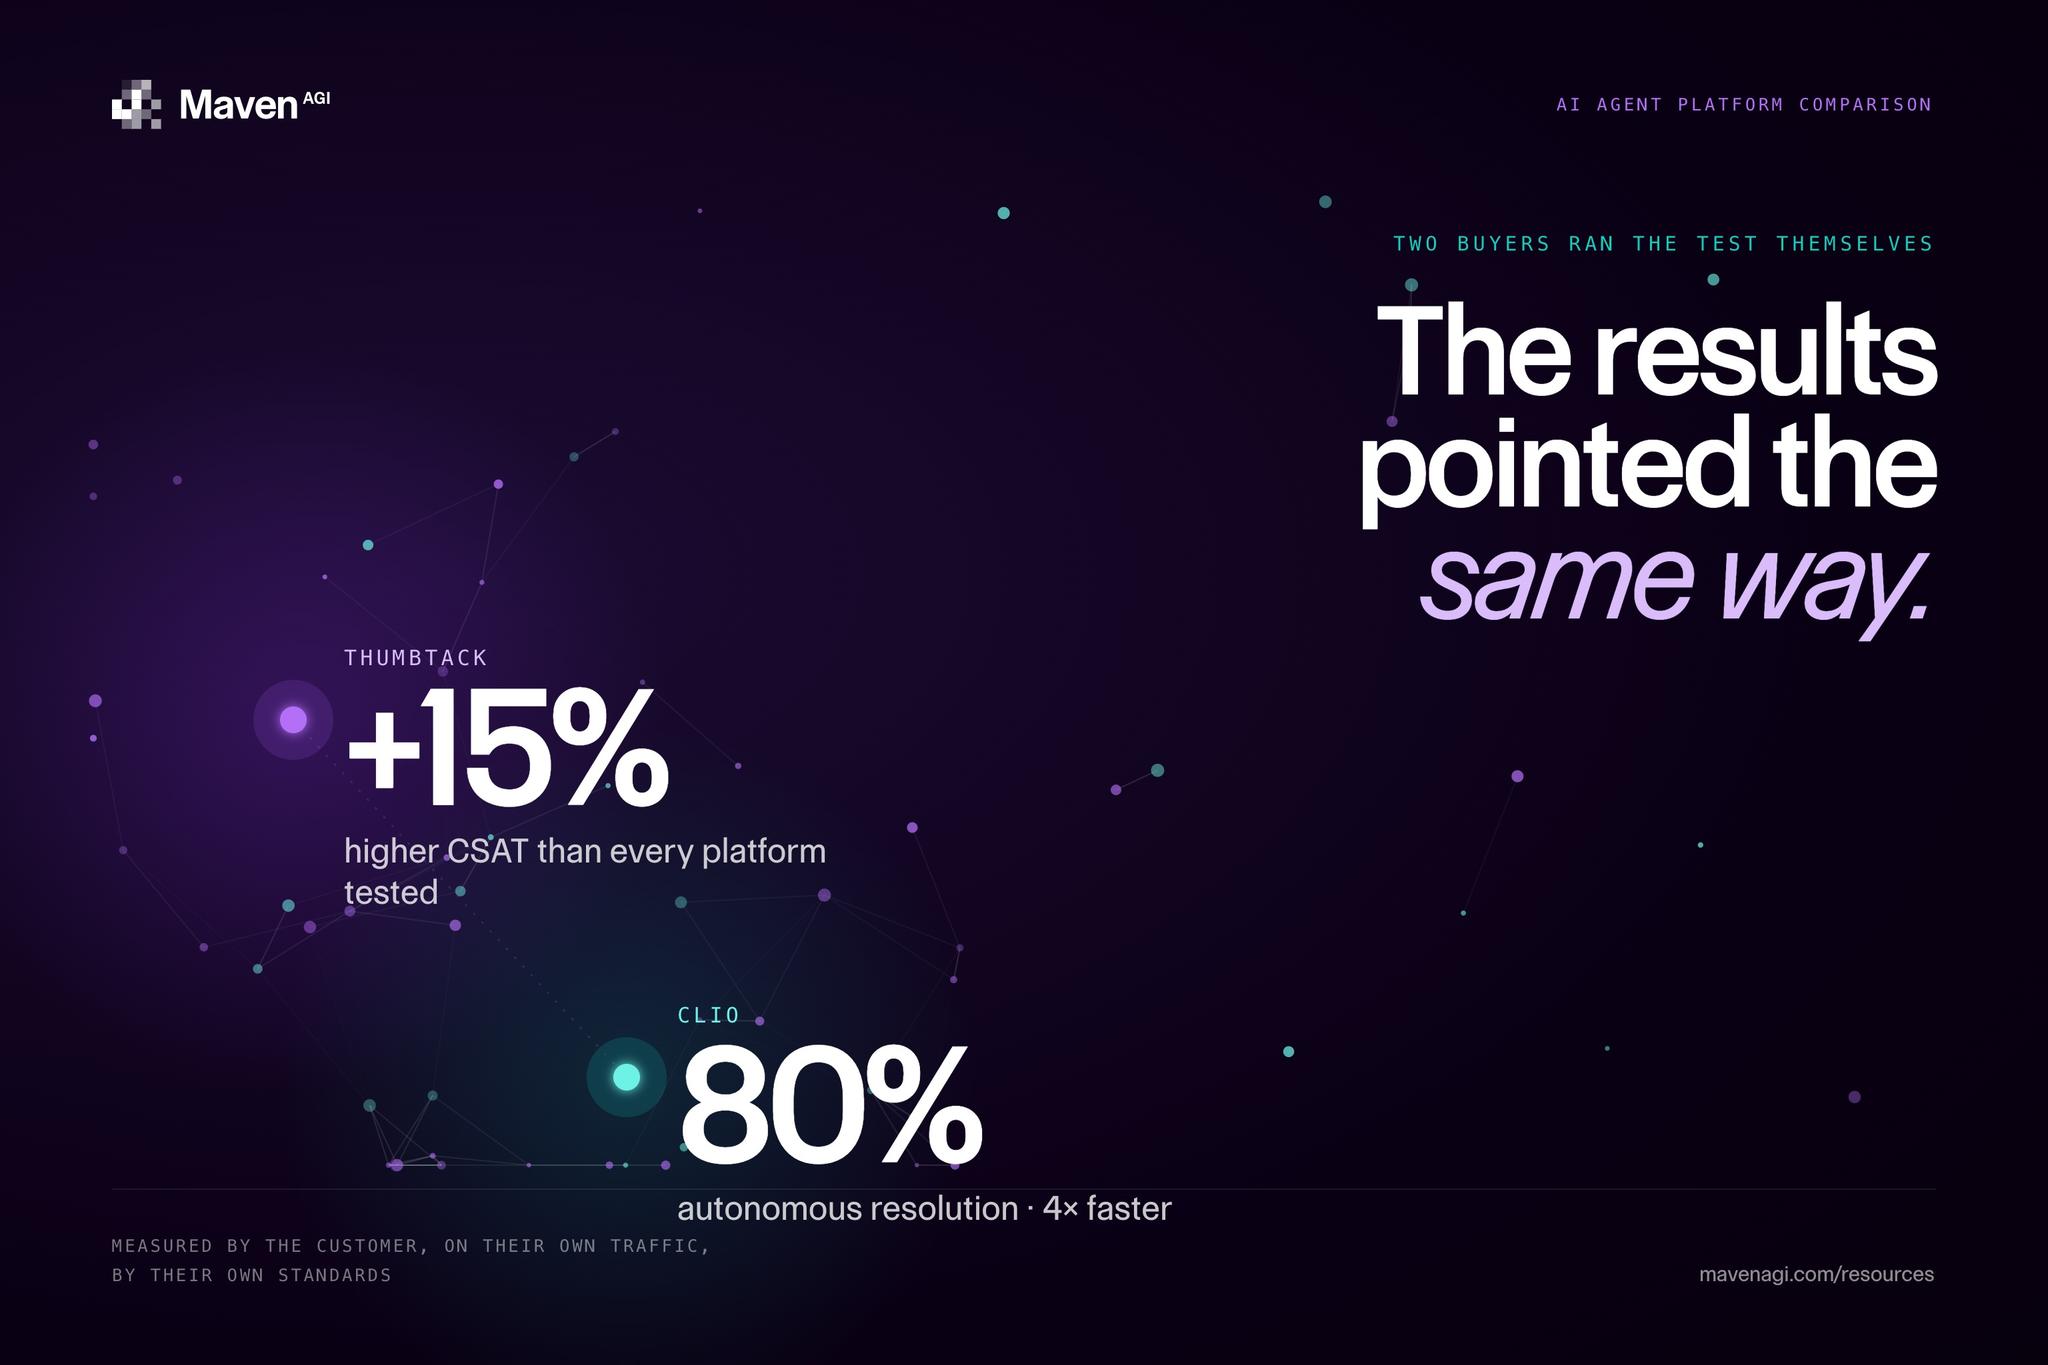
在做出决定之前,Thumbtack 团队对主流 AI 智能体平台进行了正面基准测试,用相同的真实支持流量逐一衡量。结果,Maven 的 CSAT 比参与对比的每一家竞争对手高出 15% 以上。
值得细想的是测试由谁执行。这不是 Maven 自己报告的数字,而是 Thumbtack 基于自身的业务量、对照自身的满意度基线测得的结果。参与测试的平台无法预设条件,条件由买家决定。
为什么买家主导的测试更有分量
厂商演示是受控环境:问题事先已知,数据干净整洁,棘手的边缘情况被悄悄略去。这些都无法告诉您,当一位沮丧的客户在节假日周末的晚上 11 点提出脚本从未预料到的问题时,平台会如何应对。
客户主导的基准测试去除了这种控制。真实工单以客户发送时的原样到达,满意度由并不在乎哪家厂商胜出的人来评分。平台要么解决问题并让客户满意,要么做不到。
这也正是顶尖 CX 团队与其他团队的分水岭。他们不会只凭功能清单或分析师矩阵来选择企业级 AI 智能体。他们先明确自己关心的结果——自主解决率和客户满意度——然后在签约之前,用自己的流量进行衡量。
Clio 的经历如出一辙
Thumbtack 并不是唯一这样做的买家。法律科技公司 Clio 评估了 32 家厂商,从中筛选出 10 余家进行正面比拼,最终选择了 Maven。部署后,自主解决率达到 80%,人工支持速度提升 4 倍。
2 家来自不同行业、支持模式迥异的公司,各自独立评估,却得出了相同的结论。1 个结果可能是偶然,2 个就是规律。而这两个结果都无需听信厂商的一面之词。
这对您的评估意味着什么
如果您正在评估 AI 智能体平台,关键启示与其说关乎 Maven,不如说关乎方法。做对这件事的买家,都做到了以下 4 点。
- 在演示前先定义指标。 用同一标准要求每家厂商。悄悄把分流计入其中的解决率,并不是同一个数字。
- 用真实流量测试,而非精选样本。 只有平台处理您最棘手工单的表现,才能预示其在生产环境中的表现。
- 对照真实基线评估满意度。 CSAT 提升只有相对于客户当前的体验才有意义。
- 重视实测的正面比拼,而非精美的推介。 演示文稿最好的厂商与结果最好的厂商,并不总是同一家。
按这种方式评估,营销说辞自然会去伪存真。只在受控条件下表现良好的平台,一旦面对真实的客户支持流量,很快就会原形毕露。
客户真正能感受到的指标
Thumbtack 和 Clio 衡量的,并不是有多少对话能被挡在人工之外,而是有多少客户问题真正得到解决,以及客户事后的感受。这类数字之所以站得住脚,是因为客户能直接感受到。一旦出错,代价会真实地显现:满意度评分、复购,以及一旦流失就难以重建的信任。
对于正在甄别厂商说辞的 CX 负责人,这两家公司的经验给出了同样的启示:值得入围的平台,是那些愿意用您的流量、按您的标准、由您的客户来评判结果的平台。除此之外,一切都还只是说辞。
用您自己的对话来验证。
申请免费的个性化演示。


