
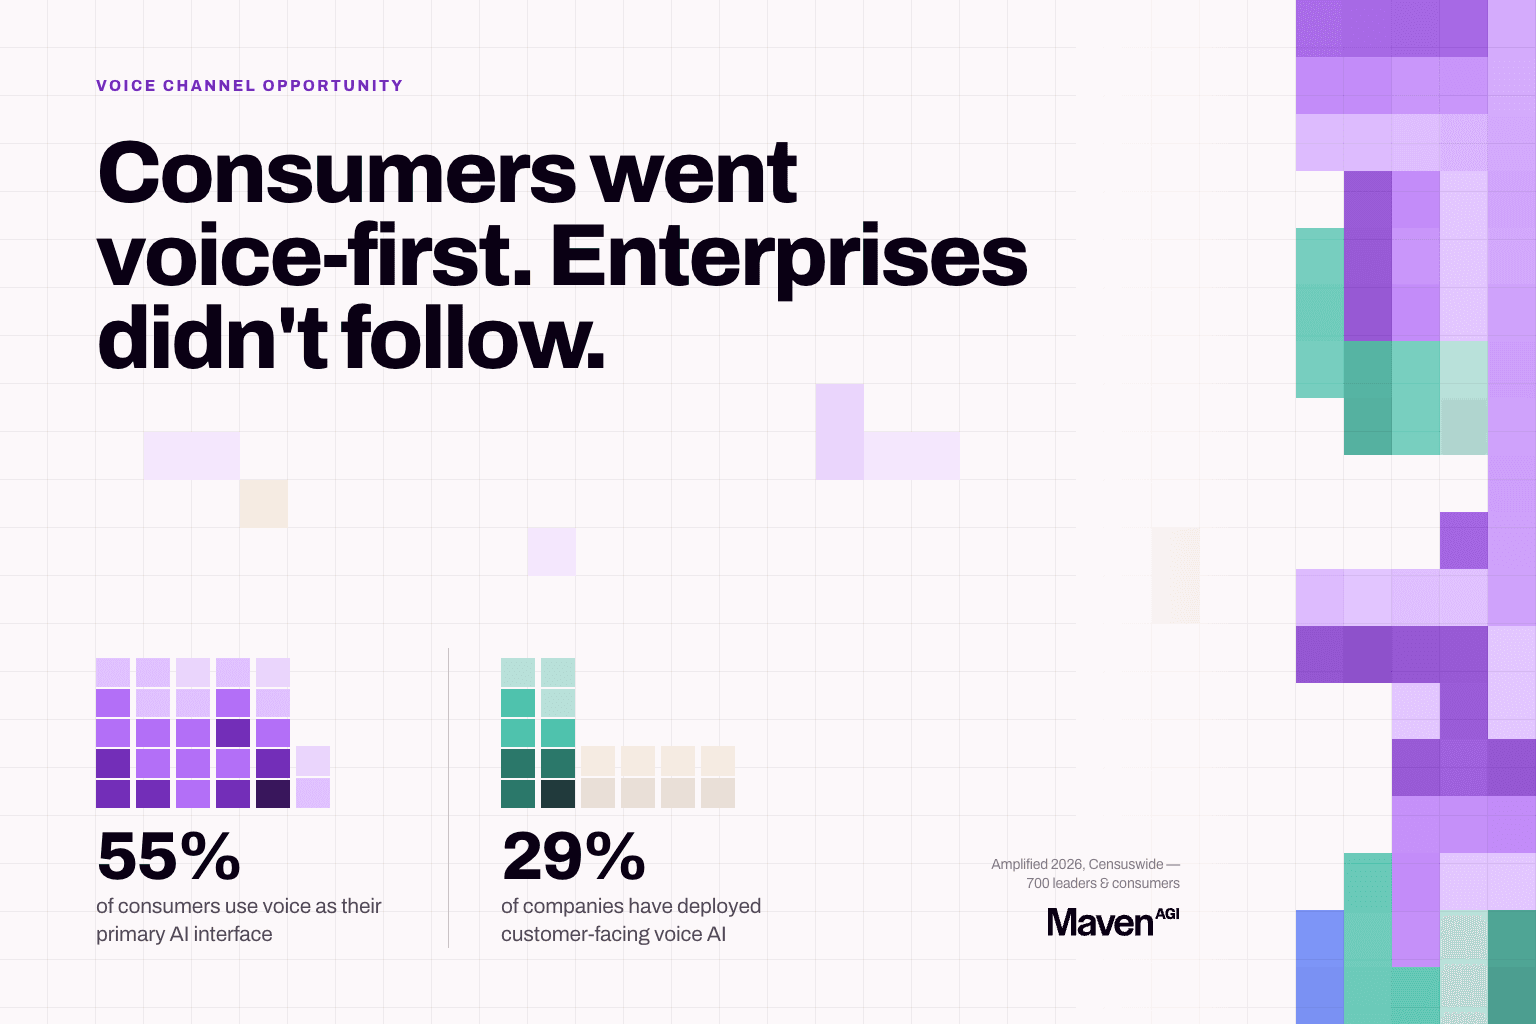
تغيّر سلوك المستهلكين تجاه الصوت أسرع من جاهزية المؤسسات. فقد وجد تقرير Amplified 2026، وهو استطلاع أجرته Censuswide وشمل 700 من قادة الأعمال والمستهلكين، أن 55% من المستهلكين يستخدمون الصوت الآن واجهةً رئيسية للتفاعل مع الذكاء الاصطناعي، في حين لم تنشر سوى 29% من الشركات ذكاءً اصطناعيًا صوتيًا موجّهًا للعملاء.
الصوت هو في آنٍ واحد القناة الأعلى حجمًا والأعلى تكلفة والأكثر تطلبًا من الناحية التقنية في خدمة العملاء، وهو أيضًا القناة التي يتأخر فيها تبنّي الذكاء الاصطناعي أكثر من غيرها. وهذا مزيج غير معتاد: فالقناة التي تتيح أكبر خفض للتكلفة هي الأقل تنافسًا على هذه الميزة.
ثلاثة عوائق جعلت الصوت صعبًا، وكانت جميعها حقيقية: زمن الاستجابة، والدقة، والامتثال. وما تغيّر هو أنها أصبحت مشكلات هندسية لها حلول، لا أسئلة بحثية مفتوحة.
لماذا كان زمن الاستجابة هو التحدي الأصعب
الطريقة المعتادة لبناء وكيل صوتي تربط 3 أنظمة في سلسلة: يُحوَّل الكلام إلى نص، ثم يقرأ نموذج لغوي النص ويكتب ردًا، ثم ينطقه نظام ثالث بصوت مسموع. كل مرحلة تعمل جيدًا بمفردها، لكن المشكلة فيما يتراكم بينها.
كل انتقال يضيف تأخيرًا، وما يختبره العميل هو المجموع. فالاستجابة في أقل من 300 مللي ثانية هي تقريبًا الحد الذي يجعل المكالمة تبدو محادثة طبيعية، وبعد ثانية تقريبًا من الصمت يبدأ الناس في الكلام مجددًا. عندها يجد خط المعالجة، الذي لا يزال يعالج العبارة الأولى، نفسه أمام مدخلين متداخلين دون طريقة واضحة للتوفيق بينهما.
والسلسلة تخسر أكثر من الوقت. فالتحويل إلى نص ينتج نصًا فقط، فلا تصمد النبرة والتردد وارتفاع الصوت وصوت نفاد صبر المتحدث بعد الانتقال الأول. يقرأ النموذج جملة مسطّحة لا تشير إلى أن قائلها على وشك إنهاء المكالمة. كما أن التعافي هشّ، لأنه عندما يقاطع العميل أو يتحدث شخصان في الوقت نفسه، يتعين على خط المعالجة اكتشاف المشكلة في مرحلة ما ثم تمرير ذلك إلى الخلف عبر مراحل لم تُصمَّم لاستقباله.
ولهذا تحقق كثير من عمليات نشر الصوت أداءً جيدًا في العرض التوضيحي ثم تتعثر في ظهيرة يوم ثلاثاء عادي. فالعروض التوضيحية هادئة ومُعدّة سلفًا وخالية من المقاطعات.
ما الذي يغيّره نموذج الصوت إلى الصوت الواحد
تُلغي بنية مختلفة هذه الانتقالات. إذ يستقبل نموذج واحد الصوت وينتج صوتًا، دون تحويل إلى نص ثم العودة منه.
ولأن النموذج يعمل على الصوت لا على نص مكتوب، يبقى ما كان خط المعالجة يُسقطه متاحًا. فالمقاطعات تصل بوصفها مقاطعات، ويصبح الكلام المتداخل والضوضاء الخلفية واللهجات غير المألوفة ظروفًا يتعامل معها النموذج لا حالات إخفاق تكسر عملية التسليم. ومع غياب المراحل الوسيطة، تضيق فجوة الاستجابة بما يكفي ليتوقف العملاء عن مقاطعة النظام.
هذه هي الآلية التي يستند إليها القول بأن زمن الاستجابة والدقة باتا محلولين في بيئة التشغيل الفعلي. فـ Maven هي أول منصة ذكاء اصطناعي مؤسسية تُدخل وكلاء الصوت إلى الصوت في التشغيل الفعلي الكامل، وهو تميّز أكدته Ibex، وتدعم 57 لغة في الصوت إلى الصوت إلى جانب 54 لغة في الدردشة. وفي عمليات النشر التي قاستها Maven، تحقق الوكلاء الصوتية المبنية جيدًا معدلات حل ضمن نطاق الدردشة نفسه في النوايا المماثلة.
وللدقة بشأن البنية التقنية: يعمل الصوت في الوقت الفعلي على OpenAI Realtime API مع نماذج الصوت من Cartesia، ويستخدم الوكيل الصوتي المحرك نفسه المستخدم في الدردشة والبريد الإلكتروني، فلا يضطر العميل الذي يتصل بعد مراسلتكم بالبريد الإلكتروني إلى البدء من جديد.
3 قرارات تحدد جدولكم الزمني الآن
بعد معالجة العوائق التقنية، تنحصر سرعة النشر في مجموعة قصيرة من الخيارات، وفي كل منها يكون الخيار الافتراضي الأسرع هو الأكثر أمانًا أيضًا في الغالب.
- الاتصالات الهاتفية. تكاملوا مع مزوّد الخدمة والبنية الحالية لديكم بدلًا من الانتقال إلى مزوّد آخر. فنادرًا ما يستحق الترحيل أن يكون الخطوة الأولى، والصوت إلى الصوت يتصل بما تشغّلونه بالفعل، بما في ذلك Twilio وVonage وCisco وZendesk Talk وGenesys.
- الرد الصوتي التفاعلي (IVR). أضيفوا طبقة فوق نظام IVR الحالي وعزّزوه بدلًا من إزالته واستبداله. فالاستبدال يتيح سقفًا أعلى لكن مساره أطول بكثير.
- التصعيد. استخدموا تسليمًا مباشرًا ينقل السياق الكامل إلى الموظف. فالتسليم دون سياق أسوأ من عدم وجود أتمتة على الإطلاق، لأن العميل يضطر إلى شرح كل شيء مرتين.
سؤال الامتثال الذي يطرحه الصوت فورًا
خلال المكالمة، يذكر العملاء معلومات لا يمكنكم تخزينها: أرقام البطاقات، والتفاصيل الصحية، وبيانات اعتماد الحسابات، وكلها تُقال بصوت مسموع أثناء طلب المساعدة.
الامتثال في الصوت أكثر صرامة منه في النص، ويُحل عندما تكون المنصة مبنية له من الأساس لا مُكيَّفة معه لاحقًا. والسؤال المهم هو التوقيت: فحجب البيانات الشخصية (PII) في الوقت الفعلي أثناء المكالمة والمعالجة اللاحقة بعدها يخلقان فترات تعرّض مختلفة، والأول وحده يُبقي البيانات الحساسة خارج خط المعالجة. اسألوا عن أيهما تشترون قبل المراجعة الأمنية لا أثناءها.
تعدد اللغات أصعب في الصوت
بلغت ترجمة النصوص مستوى كافيًا من النضج جعل معظم المؤسسات تكفّ عن القلق بشأنها. لكن الصوت ليس كذلك. فاللغة المنطوقة تحمل تنوع اللهجات، والتعابير الإقليمية، والتنقل بين اللغات في منتصف الجملة، واختلافات السرعة التي يطمسها النص المكتوب. ويضاعف خط المعالجة المتسلسل هذه المشكلة، لأن التحويل إلى نص يضطر إلى تخمين اللغة قبل أن يرى النموذج أي شيء، والتخمين الخاطئ ينتقل عبر كل المراحل اللاحقة.
تستحق أرقام التغطية التدقيق. والسؤال المفيد لأي مورّد هو: هل اختُبرت اللغات المدرجة في بيئة التشغيل الفعلي، أم أنها مجرد بنود في بطاقة النموذج؟
إثبات على نطاق واسع
تحقق مؤسسة ألعاب مدرجة في قائمة Fortune 500 وتعمل في سوق خاضعة للتنظيم معدل حل يبلغ 80% عبر أكثر من 330,000 تفاعل شهريًا، بما في ذلك 13,000 تفاعل حُلّت في يوم ذروة واحد.
أيام الذروة هي الاختبار الصادق. فطفرات الحجم هي الوقت الذي تنفجر فيه قوائم الانتظار، ويصمد فيه النظام أو يتراجع أداؤه بشكل واضح، ويكوّن فيه العملاء رأيًا راسخًا حول جدوى الاتصال بكم.
كيف تقيّمون الصوت دون الاكتفاء بالعروض التوضيحية
العروض التوضيحية المسجلة ليست دليلًا. اطلبوا مكالمة مباشرة، وتصرفوا خلالها كما يتصرف عملاؤكم.
- قاطعوا في منتصف الجملة ولاحظوا هل يتوقف الوكيل أم يواصل الكلام
- غيّروا رأيكم في منتصف الطلب
- أضيفوا ضوضاء في الخلفية
- تحدثوا بلهجة لم يستعد لها المورّد
- اطلبوا منه تنفيذ أمر ما، لا مجرد إخباركم بمعلومة
البند الأخير هو الأهم. فالإجابة عن سؤال وإتمام معاملة قدرتان مختلفتان، والحل المستقل يتطلب الثانية.
القرارات الـ 3 بصيغة مختصرة متاحة في شجرة قرارات الذكاء الاصطناعي الصوتي ، التي تُستخدم مع نطاق المشروع التجريبي لمدة 90 يومًا للفرق التي تدرس اعتماد الصوت كأول قناة مؤتمتة لديها. وكلاهما مستمد من فصل «فرصة قناة الصوت» في تقرير حالة الذكاء الاصطناعي في تجربة العملاء 2026 .
شاهدوه على محادثاتكم الفعلية.
اطلبوا عرضًا توضيحيًا مخصصًا ومجانيًا.


